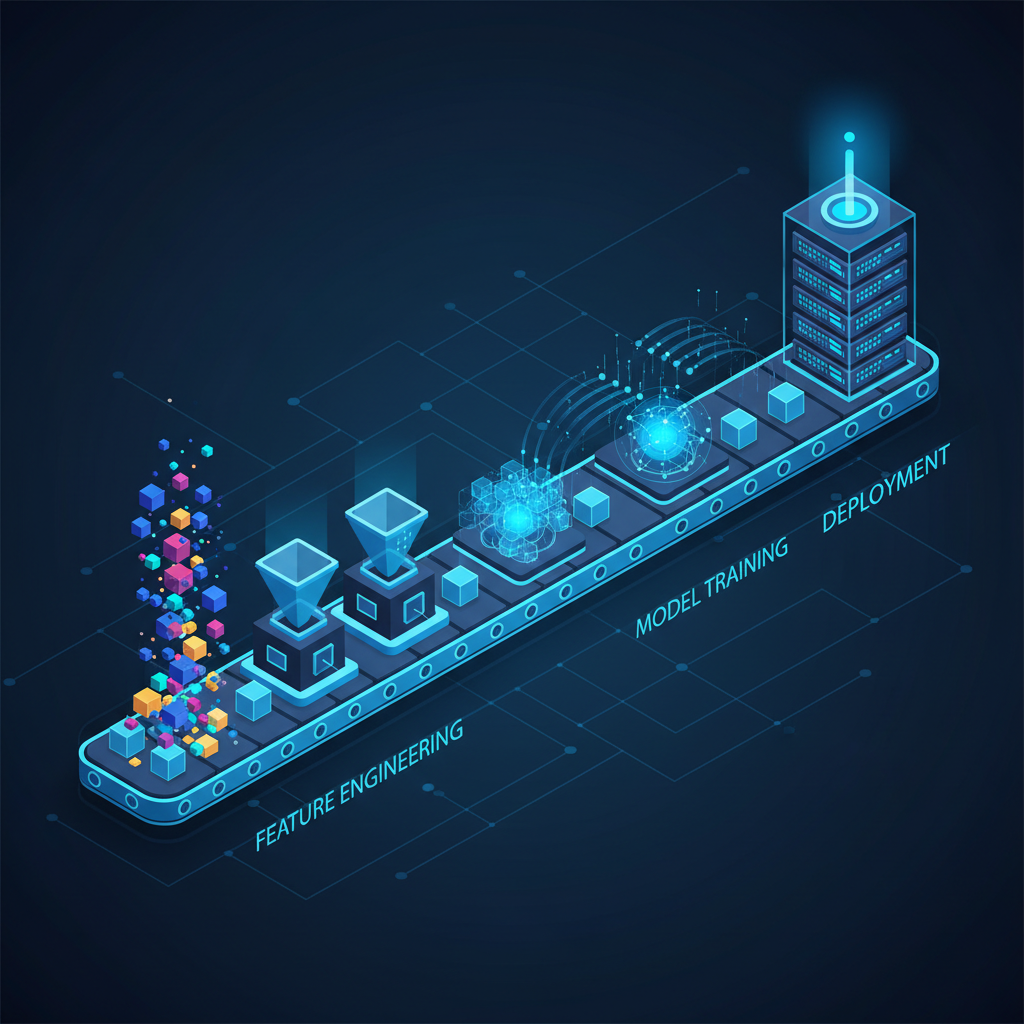
Você entra numa entrevista de ML system design, alguém diz "projete um sistema de recomendação" e em segundos a sala vira uma sopa de jargão: embeddings, feature store, model drift, class imbalance. Você acena com a cabeça enquanto afunda silenciosamente.
O problema é que quase todo material de preparação te empurra direto pra deep-dive em algoritmo ou drill de LeetCode. Mas antes disso falta o básico: um modelo mental de como um sistema de ML funciona de ponta a ponta — vocabulário, blocos de construção, e como eles se encaixam.
Existem 38 conceitos que sustentam sistemas reais (Netflix, Uber, Spotify). Aqui revisamos os 10 fundamentais que você precisa dominar antes de qualquer entrevista de ML — com contexto, links externos, e exemplos práticos.
O que é, no fundo, um sistema de ML?
Software tradicional roda em regras escritas à mão. Se a temperatura passar de 30°C, ligue o ar. Se o usuário clicar em "comprar", cobre o cartão. Cada decisão está hardcoded.
Sistemas de ML invertem a lógica. Em vez de escrever as regras, você dá milhões de exemplos ao sistema e ele descobre as regras sozinho. Mostre um milhão de corridas passadas e o modelo aprende a prever quanto tempo seu Uber vai levar. Mostre bilhões de sessões de visualização e o modelo aprende qual filme recomendar a seguir.
Parece mágico, mas é só engenharia de dados sofisticada: dados entram, padrões são extraídos, predições saem, e o sistema continua aprendendo a partir dos próprios resultados.
Cada conceito a seguir mapeia para um estágio dessa pipeline. Dominar a pipeline = dominar a entrevista.
Parte 1 — Matéria-prima: como dados viram inteligência
Você pode ter o modelo mais sofisticado do mundo. Se seus dados são lixo, suas predições são lixo. Não há atalho.
1. Features
Uma feature é uma única informação mensurável que o modelo usa pra fazer predições. Pense em features como as colunas de uma planilha que descrevem cada exemplo.
Se você está prevendo se alguém vai clicar num anúncio, suas features podem incluir: idade do usuário, hora do dia, dispositivo, e quantos anúncios já viu na sessão. Cada feature dá ao modelo um ângulo diferente sobre a mesma pergunta.
No Discover Weekly do Spotify, features incluem seus gêneros mais ouvidos, a hora que você costuma escutar, e com que frequência você pula músicas. O modelo não "ouve" a música — ele lê as features.
A qualidade das features quase sempre importa mais que a sofisticação do modelo. O que levanta a pergunta: de onde vêm boas features?
2. Feature Engineering
Feature engineering é o processo de transformar dados brutos em features que ajudam o modelo a aprender melhor. Dados brutos são bagunçados e desestruturados — feature engineering é sobre limpar, remodelar, e extrair o sinal.
É como preparar ingredientes antes de cozinhar. Você não joga um frango inteiro na panela; você corta, tempera, e organiza primeiro.
Exemplo: dado bruto do Uber pode dizer "corrida solicitada em 2024-12-25 08:47:32 UTC". Feature engineering transforma isso em: dia da semana (quarta), período (rush matinal), feriado (sim), clima (chuvoso). Cada transformação dá ao modelo um sinal mais útil que o timestamp cru.
Às vezes as features mais poderosas não estão nos dados brutos. Uma feature como "número médio de corridas que este usuário faz por semana" exige agregação em vários registros. Esse tipo de criatividade separa feature engineering boa de excelente. Bibliotecas como Featuretools e tsfresh automatizam parte disso, mas o que realmente movimenta o ponteiro é entender o domínio.
3. Labels e Ground Truth
Um label é a resposta que você está treinando o modelo a prever. Ground truth é o que realmente aconteceu no mundo real.
Se você está construindo um filtro de spam, o label de cada email é "spam" ou "não-spam". Se você está prevendo preços de imóveis, o label é o preço real de venda. O modelo aprende comparando seus chutes com essas respostas conhecidas.
Ground truth parece simples, mas é frequentemente surpreendentemente difícil de obter. Quando a Netflix pergunta "o usuário gostou deste filme?", o ground truth é ambíguo: ele assistiu até o fim? avaliou? assistiu algo similar em seguida? Definições diferentes de ground truth levam a comportamentos diferentes de modelo.
💡 Como você define seu label molda o que o modelo de fato aprende. Escolha errado, e o modelo otimiza pra coisa errada — com consequências caras em produção.
4. Treino, Validação e Teste
Você não testa um aluno com as mesmas perguntas que ele praticou. O mesmo princípio vale pra ML.
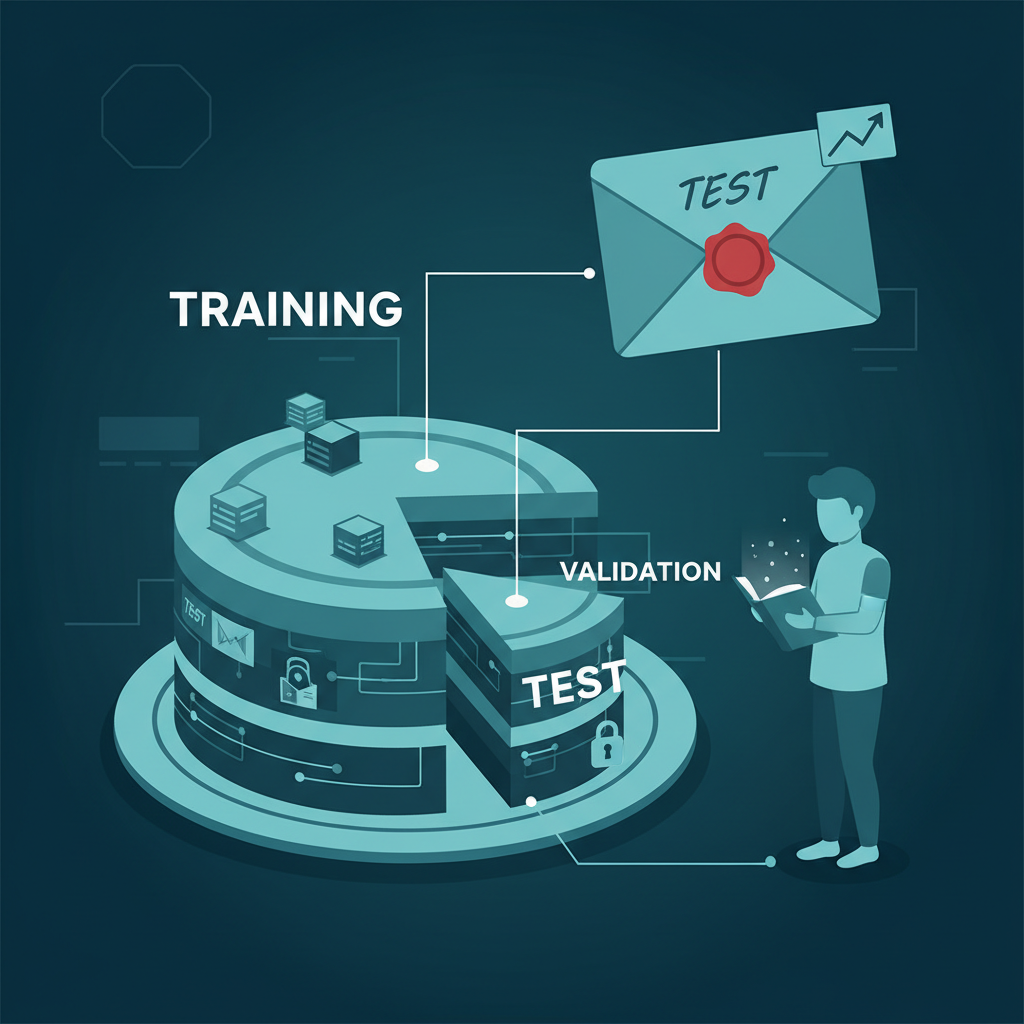
Os dados são divididos em três grupos, cada um com um trabalho específico:
- Treino: o que o modelo de fato aprende. Ele vê esses exemplos durante o treinamento.
- Validação: checkpoint de meio-de-treino. Diz qual versão do modelo está indo melhor.
- Teste: a prova final. Se o modelo se sair bem aqui, está pronto pro mundo real.
A maioria das equipes divide 70/15/15 ou 80/10/10. A proporção exata depende de quanto dado você tem, mas uma regra é inegociável: o test set nunca pode influenciar o desenvolvimento do modelo. Caso contrário, você deixou o aluno espiar a prova final — e o resultado em produção vai despencar.
Na Netflix, isso pode significar treinar com dados de visualização de janeiro a outubro, validar em novembro, e testar em dezembro. Esse time-based split é especialmente importante pra ML porque dados do mundo real mudam ao longo do tempo — fenômeno conhecido como concept drift.
5. Class Imbalance e Data Leakage
Class imbalance acontece quando um resultado é muito mais comum que os outros. Em detecção de fraude, talvez 1 em 10.000 transações seja fraudulenta. Em diagnóstico médico, a maioria dos pacientes não tem a doença rara. O modelo pode atingir 99,99% de acurácia simplesmente prevendo "não-fraude" sempre — e ainda assim ser completamente inútil.
Corrigir imbalance geralmente envolve técnicas como oversampling da classe rara (SMOTE), undersampling da classe comum, ou ajustar a loss function pra penalizar erros em exemplos raros mais pesadamente.
Data leakage ocorre quando a resposta está escondida nos dados de treino. Você está construindo um modelo pra prever entregas atrasadas, mas seu dataset inclui "reclamação de cliente registrada". Essa reclamação só existe porque a entrega já foi atrasada. Claro que o modelo parece preciso — em produção ele é inútil.
💡 Regra de ouro: se seu modelo bater 95% de acurácia na primeira tentativa, procure leakage. Se passar de 99%, procure também imbalance.
6. Data Pipelines e ETL
Data pipelines são workflows automatizados que movem dados de fontes brutas (bancos, event logs, APIs de terceiros) por uma série de transformações, até um formato que o modelo possa usar.
ETL significa Extract, Transform, Load:
- Extract: pega dado bruto da fonte.
- Transform: limpa, faz join, agrega, e engenheira features.
- Load: deposita o resultado num feature store ou dataset de treino.
É a parte de encanamento do ML. E como encanamento real, ninguém pensa nela até algo quebrar. Uma linha perdida, um valor null, um pipeline que rodou atrasado. Nenhum erro lançado — só predições silenciosamente piores.
A Uber roda milhares de pipelines de dados diariamente. Todos têm monitoramento, alerta, e quality checks. Ferramentas como Apache Airflow, Prefect, e Dagster dominam esse espaço. Mencione isso numa entrevista e você imediatamente se destaca como alguém que pensa em como ML funciona de verdade.
7. Data Versioning
Data versioning significa rastrear exatamente qual versão de um dataset foi usada pra treinar cada modelo. Assim como engenheiros de software usam Git pra rastrear mudanças de código, equipes de ML precisam rastrear mudanças de dado.
Por que isso importa? Imagine que a performance do seu modelo cai de repente. Sem data versioning, você não tem como responder: "o que mudou? foi o modelo ou os dados?". Com versioning, você compara o dataset atual com versões anteriores e identifica a mudança.
Data versioning também habilita reprodutibilidade — um requisito em setores regulados como finanças e saúde. Se um auditor pergunta "por que o modelo tomou esta decisão seis meses atrás?", você precisa conseguir recriar o modelo exato e os dados de treinamento daquele ponto no tempo.
Ferramentas como DVC (Data Version Control) e MLflow ajudam equipes a gerenciar isso. LakeFS e Pachyderm são alternativas pra cenários de data lake.
Parte 2 — Máquinas de padrão: como modelos realmente aprendem
Um modelo não "sabe" nada. Ele encontra padrões em dados e usa esses padrões pra fazer predições. Os próximos 3 conceitos descrevem exatamente como essa mágica acontece.
8. Model Training e Loss Functions
Model training é o processo de mostrar exemplos ao modelo e deixar que ele ajuste suas configurações internas até que as predições fiquem cada vez mais próximas do ground truth. É como um aluno fazendo provas práticas várias vezes, melhorando um pouco a cada uma.
O mecanismo que dirige a melhora é a loss function. Uma loss function mede o quão errado o modelo está. Após cada batch de exemplos, o modelo calcula a loss e ajusta suas configurações internas pra reduzir esse número. Ao longo de milhões de exemplos, esses pequenos ajustes somam.
Problemas diferentes pedem loss functions diferentes:
- Prever um número (como o ETA da Uber): mean squared error (MSE), que penaliza erros grandes desproporcionalmente.
- Classificar algo (spam vs. não-spam): cross-entropy loss, que mede o quão confiante o modelo estava na resposta errada.
- Ranking (busca, recomendação): pairwise loss ou listwise loss como LambdaRank.
A escolha da loss function molda o que o modelo otimiza. MSE → ser correto em média. Mean absolute error (MAE) → mais robusto a outliers. Decisões pequenas aqui têm grandes efeitos a jusante.
9. Parameters e Hyperparameters
Parameters são o que o modelo de fato aprende — pense neles como a memória do modelo: cada padrão fica codificado como um número. GPT-4 tem centenas de bilhões; um modelo simples de recomendação, alguns milhões. Você não os escreve — o modelo descobre por conta própria.
Hyperparameters são as configurações que controlam como o modelo treina. Você os define antes do treino começar:
- Learning rate: quão rápido o modelo ajusta os pesos.
- Batch size: quantos exemplos ele processa de uma vez.
- Epochs: quantas vezes ele percorre os dados.
- Arquitetura: número de camadas, neurônios, etc.
Se o modelo é o aluno, parameters são o conhecimento na cabeça dele, e hyperparameters são o plano de estudo: quantas horas por dia, quais matérias primeiro, quantos simulados.
Hyperparameters ruins fazem um bom modelo falhar. Learning rate alta demais e o modelo nunca converge. Baixa demais e treina pra sempre. Poucas epochs → underfitting. Muitas → overfitting. Na prática, equipes rodam muitos experimentos com hyperparameters diferentes e comparam resultados no validation set. Ferramentas como Optuna, Ray Tune e Weights & Biases Sweeps automatizam essa busca.
10. Embeddings — o conceito que move tudo
Um embedding é uma forma de representar algo (uma palavra, um usuário, um produto) como uma lista de números que captura seu significado.
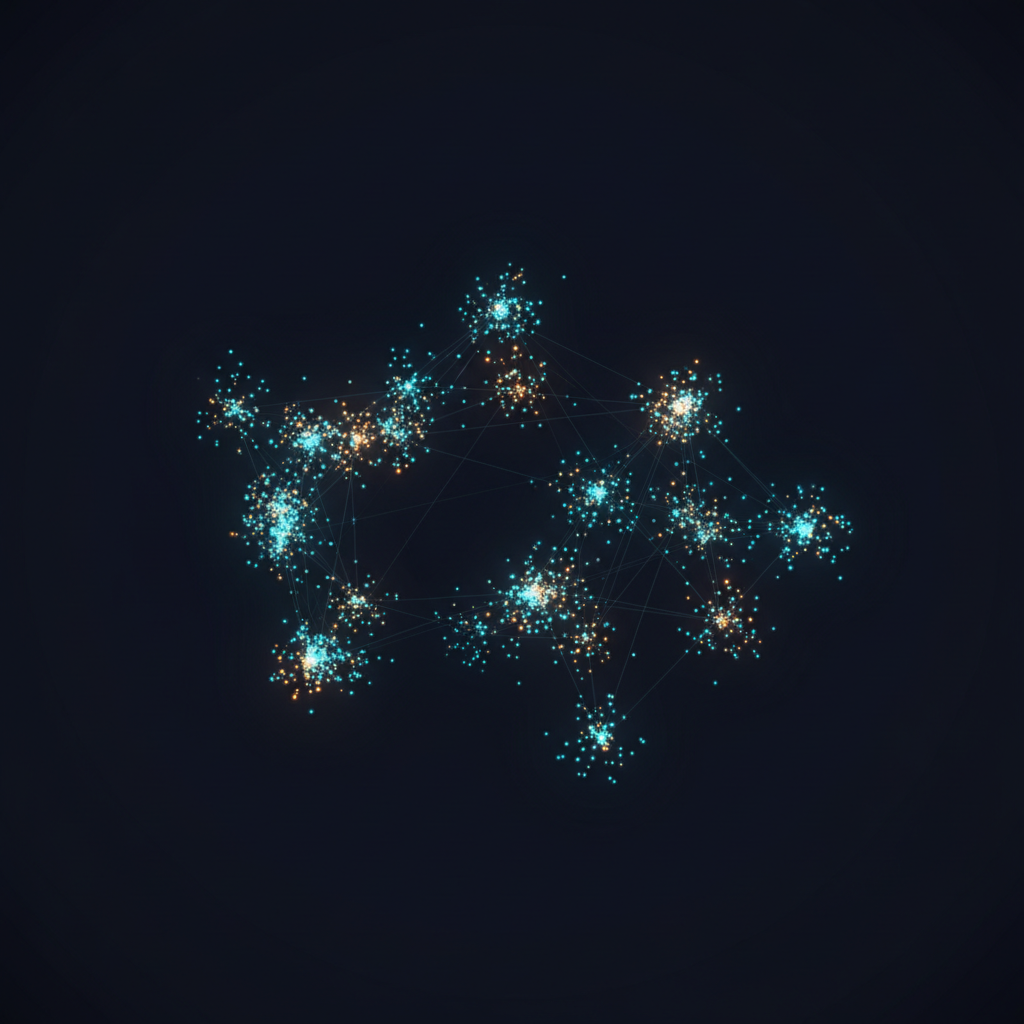
Em vez de tratar "gato" e "gatinho" como labels completamente diferentes, embeddings os posicionam próximos num espaço vetorial porque são conceitos relacionados.
Pense nisso como um mapa. Num mapa geográfico, cidades próximas estão plotadas perto uma da outra. Num espaço de embeddings, conceitos similares em significado estão plotados perto. "Comédia" e "rom-com" seriam vizinhos. "Terror" estaria distante, mas ainda na mesma galáxia de gêneros. "Contabilidade" estaria em outro universo.
Embeddings estão em todo lugar em sistemas reais:
- Spotify usa embeddings de músicas pra achar faixas musicalmente similares ao que você está ouvindo.
- Netflix usa embeddings de filme e embeddings de usuário pra cruzar viewers com filmes que provavelmente vão gostar.
- OpenAI, Cohere, Voyage oferecem APIs de text embeddings (text-embedding-3-large, voyage-3) que viram a fundação de quase todo sistema RAG moderno.
- Bancos de dados vetoriais como Pinecone, Qdrant, e Weaviate existem precisamente pra armazenar e consultar bilhões de embeddings em milissegundos.
Embeddings são como sistemas de ML dão sentido ao mundo real. Um usuário, um produto, uma sentença. Transforme em vetor, e de repente você pode calcular quais são similares, quais são relacionados, e quais recomendar.
O que vem depois — sinais de alerta e o resto do mapa
Os outros 28 conceitos cobrem: overfitting & regularization, model evaluation metrics, A/B testing, online vs offline learning, feature stores, model registries, drift detection, shadow deployments, canary releases, multi-armed bandits, recsys two-tower architectures, e por aí vai. Cada um deles preenche uma lacuna real que aparece em sistemas de produção.
Pra estudar gratuitamente em mais profundidade, três recursos canônicos:
- Machine Learning System Design Interview — livro de Alex Xu e Sahn-Lam (vol. 1 e 2), o material mais referenciado em entrevistas de big tech.
- Introduction to ML Interviews Book — de Chip Huyen, gratuito e abrangente.
- Designing Machine Learning Systems (livro + repo) — também de Chip Huyen, foco em produção.
Como praticar — o framework dos 5 passos
Em toda entrevista de ML system design, use esta espinha dorsal pra estruturar sua resposta. Mesmo que esqueça detalhes, esse mapa te impede de pular pedaços:
- Esclareça o problema — qual é a métrica de negócio? (engagement, GMV, churn). Qual é a proxy de ML? (CTR, watch time, churn probability).
- Defina dados e features — quais sinais existem? quais features novas você engenheraria? como lida com class imbalance? como evita leakage?
- Escolha modelo e loss — começa simples (regressão logística, gradient boosting) e justifica complexidade só quando necessário. Qual loss function? por quê?
- Sirva e avalie — batch ou online? feature store? latência alvo? como vai A/B testar? quais guardrail metrics te avisam de regressão?
- Itere e monitore — como detecta data drift? quando retreina? como faz rollback? como vai estar em 6 meses?
Esse framework é o mesmo que pessoas como Eugene Yan e ApplyingML usam pra raciocinar sobre sistemas reais — não é truque de entrevista, é como ML production de verdade é projetado.
Conclusão
ML system design não é decorar fórmula. É vocabulário + intuição sobre trade-offs. Quando o entrevistador joga "embeddings" na conversa, você precisa instantaneamente pensar em vector DB, dimensão, distância coseno, e quando faz sentido aprender embeddings vs. usar pre-treinados.
Os 10 conceitos acima são a fundação. Se eles ainda parecem turvos, releia esse post e os links externos antes de ir pra arquiteturas mais sofisticadas. Embeddings sem features bem definidas é castelo de areia. Modelo perfeito com leakage no dataset é fraude estatística.
Próximos conceitos pra estudar (e que aparecem em quase toda entrevista sênior): two-tower architectures pra recsys, multi-stage ranking (candidate generation → ranking → re-ranking), feature stores (Tecton, Feast), model drift detection, e shadow deployment. Cada um deles merece um post próprio — e provavelmente vamos cobrir em entradas futuras desse blog.