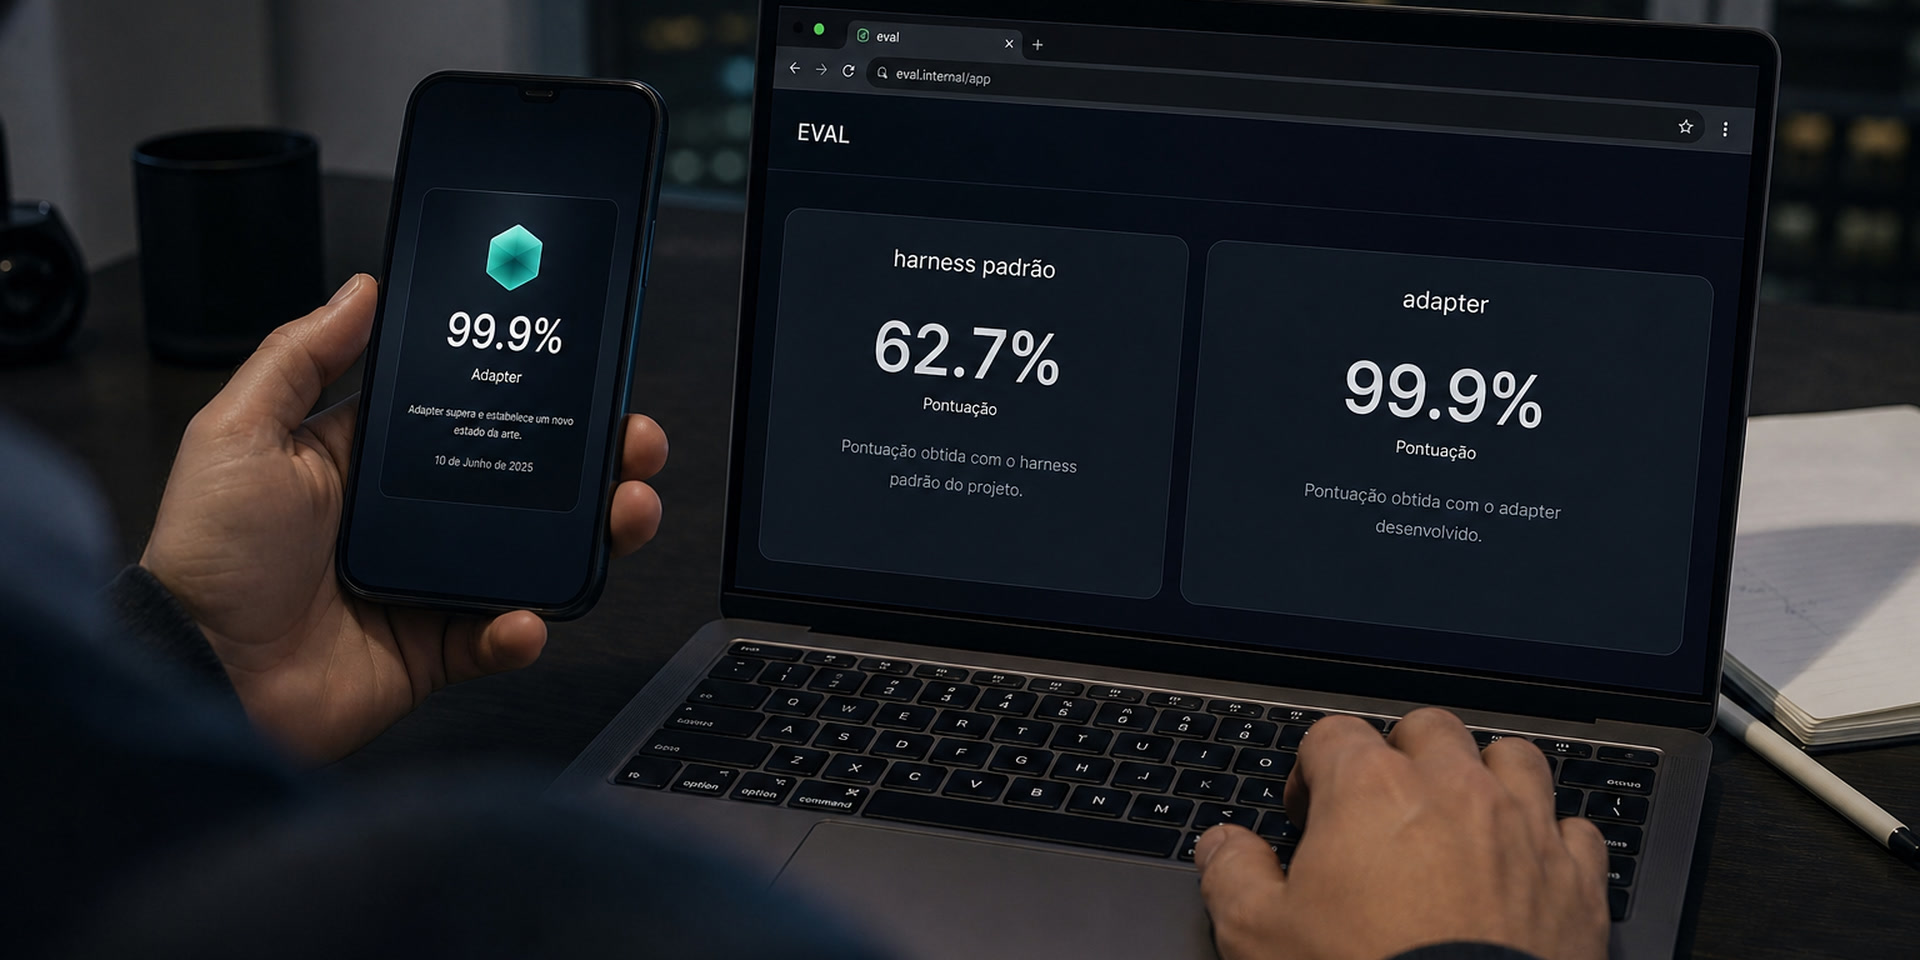
Toda vez que um modelo novo chega, o feed entrega um card com três porcentagens. Desta vez: GPT-6 Astra. 98%. 99,9%. 100%. A tentação é copiar e colar. Eu abri as páginas.
A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026, no post oficial. É o sucessor da família GPT-5.6 (Sol, Terra, Luna). O texto fala em código, pesquisa, uso de computador e trabalho de vários passos. O rollout: organizações limitadas hoje; Plus, Pro, Business, Enterprise, API e AWS nos próximos dias. Ainda não é disponibilidade geral. Na API o id é gpt-6-astra. Preço Standard: US$ 10 / US$ 50 por milhão de tokens (input/output). Também no Amazon Bedrock.
Isso é fato. O resto do card merece asterisco.
O 99,9% tem um harness
A ARC Prize publicou os números no mesmo dia. No harness padrão (o que compara provedor com provedor, notas visíveis, interface mínima), o Astra (max) fez 62,7% no ARC-AGI-3 Semi-Private, a uns US$ 26 mil de custo de avaliação. No harness Provider Adapter (que guarda o raciocínio opaco entre requests e compacta conversa longa), o Astra (high) fez 99,9%, a uns US$ 19 mil.
Os dois são SOTA. Não são o mesmo teste.
A ARC Prize foi explícita: saturar o ARC-AGI-3 não é prova de AGI. O benchmark mede exploração, modelo de mundo, objetivo e planejamento em jogos novos. O Astra, no Adapter, usou menos ações que a mediana humana em 96% dos níveis. Isso é um salto. Continua sendo um ambiente fechado, determinístico, com mecânica e meta definidas. Não é o mundo aberto.
Se alguém te mandar só “99,9% no ARC-AGI-3”, pergunta: qual harness?
ExploitBench 100% é número da OpenAI
No post de lançamento, a OpenAI escreve que o Astra satura o ExploitBench com 100%. Na tabela do mesmo post: Astra 100,0%, GPT-5.6 Sol 78,5%. Por risco de contaminação, eles montaram o ExploitBench – Internal Port (junho–agosto de 2026) com 20 CVEs recentes do V8. Aí o número cai: Astra 39,0% de execução arbitrária de código versus Sol 11,5%. No Path to Astra eles ainda relatam o Astra usando dois zero-days numa cadeia — em divulgação com os maintainers.
O 100% é o conjunto histórico, com asterisco de contaminação. O 39% é o conjunto recente, ainda interno. Eu não achei laboratório independente republicando nenhum dos dois com o código da eval aberto. Trate como claim da OpenAI até uma réplica externa.
O que a OpenAI designou é mais importante que o porcentual: o Astra é o primeiro modelo no limiar Critical de cibersegurança do Preparedness Framework. Tradução deles: com as ferramentas certas, o modelo consegue achar falha desconhecida e montar exploit em sistemas endurecidos, sem humano guiando cada passo. Por isso o cyber avançado começa em alpha / Daybreak Blue, não no ChatGPT de todo mundo.
O 98% de FrontierMath: prosa da OpenAI, não a Epoch
No post de lançamento, a OpenAI escreve 98% na prosa e 97,6% na tabela do FrontierMath Tier 4 (v2). Na mesma tabela, Claude Fable 5 aparece com 87,8% e o Sol com 80,5%. A página da Epoch do FrontierMath Tier 4 v2 descreve o benchmark (43 problemas privados no Tier 4 depois da correção de junho de 2026) e o conflito de interesse (OpenAI financiou e tem acesso exclusivo a um subconjunto). Não encontrei o Astra listado na tabela da Epoch no momento em que escrevi. 98% e 97,6% são números da OpenAI até a Epoch publicar. Não vou arredondar um no outro.
Atrasaram de propósito
Isso, sim, a OpenAI documentou. Depois do incidente com a Hugging Face — modelo não era o Astra, era da linha Sol — eles pausaram treino, endureceram isolamento e só retomaram o RL grande em 28 de agosto. O Path to Astra é o texto de “seguramos o lançamento até o Preparedness deixar passar”. Recusa a jailbreak de cyber: 91,5% no Astra versus 59% no Sol, número deles. No mesmo lançamento, a OpenAI diz que o raciocínio escrito do Astra ficou mais difícil de monitorar do que o do Sol. Eles tratam isso como prioridade de pesquisa. Tempo extra de safety não é alignment resolvido. Monitor de desalinhamento pode pausar a conversa no ChatGPT/Codex se o agente parecer fora do combinado.
Greg Brockman, em briefing, falou em “era AGI”. A ARC Prize, no mesmo dia, recusou esse salto. Os dois textos cabem na mesma tarde. Você escolhe qual lê primeiro.
O que isso muda pra quem constrói
Computer use, browser, planilha, apresentação, código em repositório de verdade: é o pitch. A API ganhou async tool calling, steering no meio do turno e mudança de esforço de raciocínio sem quebrar o cache. none de reasoning o Astra não tem. Fast mode não roda com residência de dados na UE.
Na prática, pra quem já vive de agente:
- Não rode o score do card. Abra a página da eval. Harness padrão versus adapter. Interno versus público.
- Cyber Critical não é “pode pentestar o cliente”. Default vem mais travado. Daybreak é outro produto.
- O modelo pergunta mais. A própria OpenAI admite: o Astra para e pede clarificação onde o Sol chutava. Se o seu agente precisa terminar sozinho, o prompt de iniciativa vai ter que ser explícito — ou você aprova o último passo, que é o que eu já faço.
- Ainda não está no plano grátis. Espera a janela de Plus/Pro. Não inventa acesso.
- Preço Standard da API: US$ 10 / US$ 50 por milhão de tokens (input/output). Fast mode: até 2× a velocidade, 2× o preço. Também no Amazon Bedrock.
Eu não vou chamar isso de AGI. Vou chamar de modelo que, no teste interativo da ARC, aprende a regra do jogo mais rápido que a mediana humana — e que, no teste de cyber da OpenAI, passou do limiar que eles mesmos desenharam. São duas frases. Nenhuma delas cabe num card de 99,9%.
Quando a Epoch publicar o Tier 4 e a system card sair com a metodologia do ExploitBench, eu volto aqui e corrijo o que estiver frouxo.