“Roda em 16 GB” é uma resposta incompleta. No meu benchmark, o mesmo clipe de 5,06 segundos levou 5min55s no pipeline mais rápido da rodada controlada e 50min48s no modelo maior. Em outro perfil, o Hunyuan passou de três horas.
A pergunta, portanto, não é apenas se a GPU consegue executar o modelo. É quantas ideias você consegue explorar em uma tarde e em que momento um take merece ser promovido para um pipeline mais caro.
Minha conclusão curta: numa RTX 5060 Ti de 16 GB, o Wan 2.2 TI2V 5B serve para pensar; Wan 2.2 A14B Q5 e HunyuanVideo 1.5 servem para apostar em um take já decidido. Os modelos maiores rodam com quantização e offload, mas são lentos demais para explorar às cegas.
O que foi testado
A bateria reuniu texto-para-vídeo, texto+imagem-para-vídeo, imagem-para-vídeo e dois experimentos de áudio. O ambiente foi o mesmo do teste de imagens: Windows, RTX 5060 Ti de 16 GB, 96 GB de RAM, ComfyUI 0.34.0 e execução sequencial.
- T2V: o clipe nasce apenas do texto.
- TI2V: o workflow Wan aceita texto e imagem; nesta bateria apareceu em perfis comparativos.
- I2V: uma imagem de referência condiciona identidade e composição.
- InfiniteTalk: pipeline especializado em fala e sincronização.
- TTS mux: apenas adiciona áudio ao MP4; não reescreve a boca e não prova lip-sync.
Essas siglas mudam o trabalho executado. Um I2V precisa preservar a referência; um T2V constrói a cena do zero; um pipeline de fala resolve ainda outro problema. Misturar tudo em uma tabela e declarar um vencedor produziria um ranking fácil de ler e difícil de defender.
A rodada controlada que mais importa
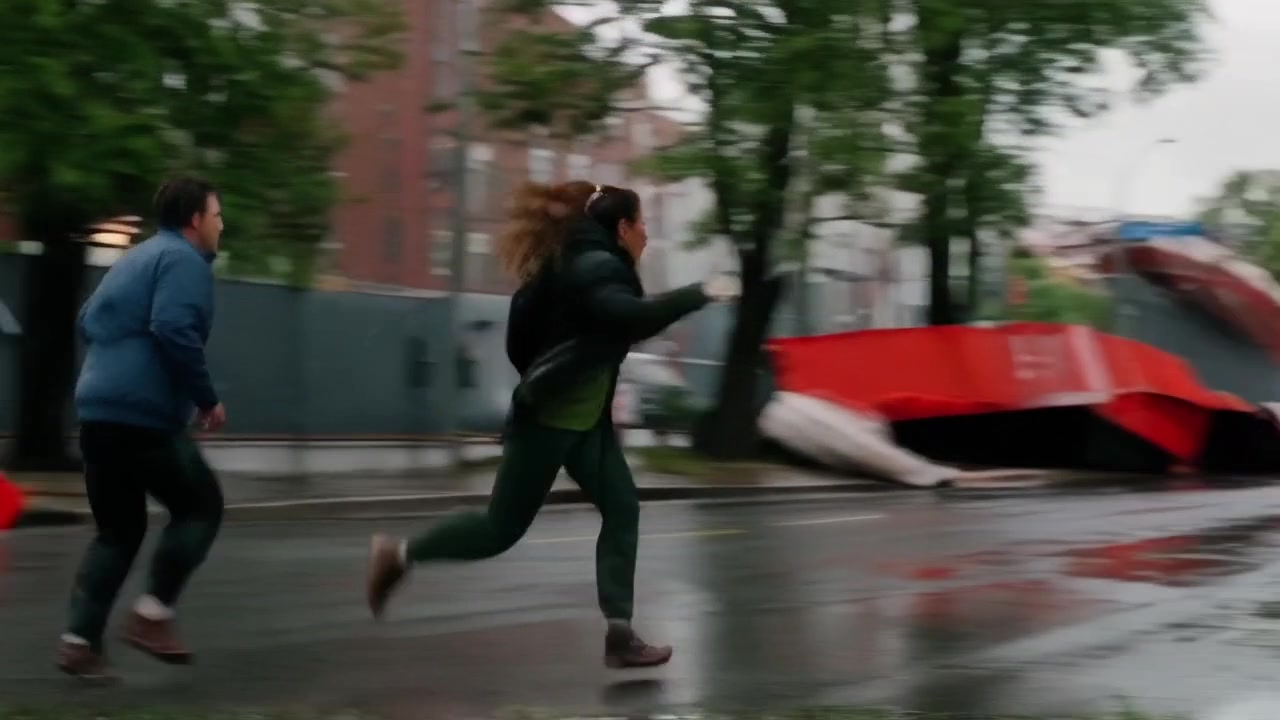
O comparativo mais limpo usou texto puro, seed 20260916, resolução 1280×720, 81 frames, 16 fps e duração de 5,06 segundos. Sem imagem de referência.
Ver o prompt T2V de ação
Photorealistic cinematic action scene with two adult real human characters, a woman and a man in practical modern outdoor clothing, sprinting across a rain-soaked city street while escaping a collapsing construction barrier, the woman jumps over debris and the man follows, powerful full-body movement, hair and clothing reacting to the wind, handheld tracking camera, dramatic daylight, realistic skin and anatomy, coherent faces, natural motion blur, wide shot, high-end live-action film, no fantasy, no animation, no text, no subtitles.
| Modelo | Resolução | Frames/FPS | Clipe | Tempo |
|---|---|---|---|---|
wan22_t2v_5b | 1280×720 | 81 / 16 | 5,06s | 5min55s |
wan22_a14b_q5_t2v | 1280×720 | 81 / 16 | 5,06s | 50min48s |
Com os parâmetros alinhados, o 5B foi 8,6 vezes mais rápido. O A14B construiu uma cena mais densa e escura; o 5B entregou ação legível, rua molhada e movimento lateral. O modelo menor não vence em tudo, mas deixa responder a pergunta mais urgente muito antes: esta ideia funciona em movimento?
Como ler os clipes: tempo e formato vêm do manifesto. Qualidade temporal não recebeu uma nota humana estruturada nesta rodada. Os vídeos devem ser assistidos por inteiro; um frame bonito não mede flicker, coerência de movimento, ritmo de câmera ou deformação entre quadros.
Todos os tempos úteis da bateria
| Perfil | Pipeline | Formato | Tempo | Segundos gerados |
|---|---|---|---|---|
| T2V ação controlada | Wan 2.2 5B | 1280×720 · 81/16 | 5min55s | 5,06s |
| T2V ação controlada | Wan 2.2 A14B Q5 | 1280×720 · 81/16 | 50min48s | 5,06s |
| Manga | Wan 2.2 TI2V 5B | 1280×720 · 121/24 | 14min11s | 5,04s |
| Manga | Wan 2.2 A14B Q5 | 1280×720 · 81/16 | 44min02s | 5,06s |
| Manga | HunyuanVideo 1.5 | 1280×720 · 81/16 | 1h42min20s | 5,06s |
| I2V horizontal | Wan 2.2 TI2V 5B | 1280×720 · 121/24 | 11min12s | 5,04s |
| I2V horizontal | Wan 2.2 A14B Q5 | 1280×720 · 81/16 | 42min23s | 5,06s |
| I2V horizontal | HunyuanVideo 1.5 | 1280×720 · 81/16 | 3h27min30s | 5,06s |
| I2V vertical | Wan 2.2 TI2V 5B | 720×1280 · 121/24 | 10min51s | 5,04s |
| I2V vertical | Wan 2.2 A14B Q5 | 720×1280 · 81/16 | 41min49s | 5,06s |
| I2V vertical | HunyuanVideo 1.5 | 720×1280 · 81/16 | 1h49min29s | 5,06s |
| I2V expressões | Wan 2.2 TI2V 5B | 720×1280 · 121/24 | 10min41s | 5,04s |
| I2V expressões | Wan 2.2 A14B Q5 | 720×1280 · 81/16 | 42min57s | 5,06s |
| I2V ação | Wan 2.2 TI2V 5B | 720×1280 · 121/24 | 10min26s | 5,04s |
| I2V ação | Wan 2.2 A14B Q5 | 720×1280 · 81/16 | 42min42s | 5,06s |
| Fala | InfiniteTalk + Wan 2.1 | 720×1280 · 113/16 | 3h07min03s | 7,06s |
A maior diferença direta apareceu no I2V horizontal: 11min12s no Wan 5B contra 3h27min30s no Hunyuan, cerca de 18,5 vezes. Em termos de produção, é a distância entre comparar cinco tentativas durante o trabalho e ocupar a máquina por metade do dia com uma única variação.
Regra para ler a tabela: use o 5B para eliminar ideias ruins cedo. Só pague o custo de A14B ou Hunyuan quando enquadramento, ação e direção de câmera já tiverem sobrevivido à triagem.
A estética muda tanto quanto o tempo
No perfil manga, os três pipelines receberam a mesma direção: mulher ruiva adulta, vestido preto, apartamento luxuoso ao pôr do sol, linha limpa, cel shading e câmera suave. Os resultados não convergiram para o mesmo desenho. Cada modelo trouxe uma interpretação própria de personagem, enquadramento e intensidade da luz.
O Hunyuan levou 1h42min20s no mesmo perfil e produziu outra personagem, com outro grau de estilização. Sem uma rubrica temporal e múltiplas seeds, não dá para afirmar que o tempo adicional compra qualidade de forma consistente. Ele compra outra distribuição de resultados, e explorar essa distribuição custa caro.
O perfil realista expõe o trade-off
Este trio é valioso justamente porque não permite uma conclusão fácil. Os arquivos vieram de uma rodada antiga cujo manifesto não preservou os tempos. Os clipes continuam úteis como evidência visual, mas não sustentam uma comparação de velocidade. Benchmark bom também mostra onde o dado termina.
Por que 16 GB bastam para rodar, mas não para correr
O Wan 2.2 TI2V 5B usa um modelo de aproximadamente 10 GB, VAE de cerca de 1,4 GB e text encoder quantizado de aproximadamente 6,7 GB. O workflow consegue trabalhar com os 16 GB sem depender do mesmo nível de offload dos modelos maiores.
O Wan 2.2 A14B em precisão cheia ultrapassa o orçamento de VRAM. A solução usada foi GGUF Q5, com dois experts de aproximadamente 10,79 GB cada e troca entre high-noise e low-noise durante a amostragem. A GPU executa, mas os 96 GB de RAM e o offload entram no caminho. Nesse ponto, “caber” e “ser rápido” deixam de ser sinônimos.
HunyuanVideo 1.5 também roda com offload. LTX-2.5 foi validado fora da bateria principal em 384×384, 121 frames, 24 fps e oito passos: 2h10min37s para 5,04 segundos de vídeo. O arquivo era válido e não preto, mas a experiência confirma a mesma regra: memória de sistema pode viabilizar um modelo; não transforma a GPU em uma placa maior.
O fluxo que transforma horas em decisões
- Escreva o plano do take. Sujeito, ação, câmera, ambiente, luz, estilo e áudio em campos separados.
- Gere curto. Cinco segundos revelam prompt ruim, enquadramento errado e movimento impossível sem gastar uma tarde.
- Comece no Wan 5B. Use 480p ou 720p e reduza frames antes de ativar
--lowvramou offload mais agressivo. - Congele tudo. Seed, resolução, frames, FPS, passos, scheduler, negative prompt e versão do workflow.
- Assista do começo ao fim. Avalie identidade, anatomia, flicker, câmera, trajetória, deformações e último frame.
- Promova um take. Só então tente A14B, Hunyuan ou um pipeline especializado.
- Edite fora do gerador. Corte, montagem, som, cor e legendas não precisam ser pagos novamente em tempo de difusão.
Prompt de vídeo: o que precisa estar explícito
Para imagem, descrever sujeito, composição e luz costuma bastar. Para vídeo, o prompt precisa carregar tempo. Eu uso esta ordem:
- Sujeito: quem aparece e quais atributos não podem mudar.
- Ação: um verbo observável, com começo e direção.
- Câmera: enquadramento, lente, trajetória e velocidade.
- Ambiente: espaço, hora, clima e elementos que reagem.
- Movimento secundário: cabelo, roupa, fumaça, chuva, reflexos.
- Estilo: live action, anime, publicidade, documentário.
- Restrições: sem texto, sem legenda, sem personagem extra.
Um prompt cheio de adjetivos e sem ação tende a produzir um pôster que respira. No extremo oposto, três ações, duas câmeras e uma mudança de cenário em cinco segundos pedem ao modelo uma montagem inteira dentro de um único take. Melhor dividir a cena.
Áudio: mux não é lip-sync
Um experimento adicionou TTS ao clipe em 0,7 segundo. Esse número mede apenas o mux: colocar a faixa de áudio dentro do MP4. A boca não foi reprocessada. Chamar isso de lip-sync seria falso.
O InfiniteTalk gerou 7,06 segundos em 3h07min03s, mas uma avaliação séria precisa ouvir o áudio e observar fonemas, atraso, fechamento labial e estabilidade do rosto. Também precisa alinhar exatamente a duração da fala ao vídeo. Áudio presente é uma coluna booleana; sincronização é uma avaliação humana.
Licença também faz parte do pipeline
Executar o modelo localmente não apaga sua licença. O Wan 2.2 TI2V 5B é distribuído sob Apache 2.0. O HunyuanVideo 1.5 usa a licença comunitária da Tencent, cujo território exclui União Europeia, Reino Unido e Coreia do Sul. A licença da família LTX-2, que cobre o LTX-2.5 deste setup, exige licença comercial paga para entidades com receita anual a partir de US$ 10 milhões. Antes de colocar uma saída em campanha, produto ou banco de mídia, confira a licença da versão exata e o território de uso.
Como repetir o benchmark sem se enganar
- Use pelo menos quatro seeds por perfil.
- Não compare 121 frames a 24 fps com 81 frames a 16 fps como se o custo fosse equivalente.
- Separe T2V, TI2V, I2V e fala.
- Registre tempo de geração, duração, FPS real, frames, resolução e tamanho do arquivo.
- Use uma rubrica de 1 a 5 para aderência, estabilidade temporal, deformação, identidade e lip-sync.
- Não sobrescreva resultados antigos; evolução de workflow precisa de histórico.
- Valide o MP4 com
ffprobee assista com áudio antes de aprovar.
Então, vídeo local vale a pena?
Vale para quem precisa de privacidade, controle, experimentação sem créditos e disponibilidade do pipeline. O custo real, porém, é throughput. Cinco segundos finais podem exigir dezenas de tentativas; quando cada tentativa pesada se aproxima de uma hora, a arquitetura de trabalho importa mais que o modelo da moda.
Na GPU de 16 GB deste teste, a decisão prática ficou simples: Wan 5B para pensar, A14B ou Hunyuan para uma tentativa final justificada, e pipelines de fala apenas quando o áudio for central ao resultado. O hardware conseguiu rodar tudo. O benchmark revelou o dado que normalmente desaparece atrás do “sim, roda”: quanto tempo custa chegar a cada tentativa.
Se você ainda está montando a base, comece pelo teste anterior: 133 gerações de imagem local sem pagar por imagem.