Faz uns meses que me pego fazendo o mesmo ritual. Mexo no prompt do agente, rodo duas ou três conversas de teste, leio as respostas e penso: "ficou melhor". Depois alguém me manda um caso que antes funcionava e agora quebrou. Aí percebo que eu só tinha olhado para os exemplos que eu mesmo escolhi, do jeito que eu mesmo gosto de perguntar.
Este texto é sobre como sair desse ciclo. A ferramenta se chama evals: uma forma barata e repetível de responder à pergunta "essa mudança melhorou ou piorou o meu agente?". Não precisa de infraestrutura sofisticada. Precisa de disciplina e de uma planilha honesta.
Por que "parece melhor" engana
Agentes são sistemas variáveis. A mesma pergunta pode render respostas diferentes em duas execuções seguidas. Então, quando eu testo à mão, três coisas atrapalham.
- Amostra minúscula. Três conversas não representam o que os usuários de verdade vão fazer.
- Viés de quem escreveu a mudança. Eu ajustei o prompt pensando num problema específico, então testo justamente esse problema e fico feliz quando ele some.
- Memória seletiva. Lembro da resposta bonita e esqueço da que escorregou. Em agentes que usam ferramentas, um erro no meio do caminho pode passar despercebido se o texto final soar confiante.
O resultado é que cada ajuste conserta uma coisa e quebra outra, e ninguém percebe até o usuário reclamar. Evals existem para transformar essa sensação vaga em um registro que dá para consultar.
Comece pequeno e com casos reais
A tentação é montar um conjunto enorme e perfeito. Não faça isso. Um conjunto pequeno, que você realmente roda, vale mais que um grande que ninguém tem paciência de manter.
As melhores fontes de casos são as mais mundanas: conversas reais que deram errado, pedidos que o suporte repete toda semana, perguntas que você já sabe que são difíceis. Se o agente ainda não está em produção, escreva os casos como se fosse um usuário cansado e apressado, não como um desenvolvedor educado. Gente de verdade escreve com erro de digitação, omite contexto e muda de assunto no meio.
Cada caso precisa de três ingredientes: a entrada (a mensagem do usuário e, se for o caso, o estado inicial), o que se espera como resultado e uma etiqueta dizendo que tipo de situação aquilo cobre. As etiquetas ajudam depois, quando você quiser saber se a piora está concentrada em algum tipo de tarefa.
Critérios objetivos primeiro, julgamento por modelo depois
Existem duas grandes maneiras de dizer se um caso passou.
A primeira é a verificação objetiva, feita por código. O agente chamou a ferramenta certa? O JSON de saída é válido? A resposta contém o número do pedido correto? Ele recusou quando devia recusar? Essas checagens são rápidas, baratas, determinísticas e não discutem com você. Sempre que um critério puder ser escrito assim, escreva assim.
A segunda é o julgamento por modelo: outro modelo lê a resposta e a avalia seguindo um roteiro. Serve para o que é difícil de codificar, como tom adequado, clareza ou se a explicação faz sentido. Funciona, mas pede cuidados:
- Escreva o roteiro de avaliação com critérios concretos ("a resposta menciona o prazo? sim ou não"), não com adjetivos ("a resposta é boa?").
- Prefira perguntas de sim ou não a notas de 1 a 10. Notas oscilam e ninguém sabe o que significa um 7.
- Leia por conta própria uma amostra dos veredictos. Se o avaliador discorda de você com frequência, o problema está no roteiro dele, não no agente.
- Se possível, use um modelo ou configuração diferente do que está sendo avaliado, para reduzir a tendência de elogiar o próprio estilo.
Minha regra prática: objetivo para tudo que dá, julgamento por modelo para o resto, e revisão humana nos casos em que os dois discordam.
Rode a cada mudança, sem exceção
Um eval só protege se for rodado sempre. Trocou uma frase do prompt? Rode. Atualizou a versão do modelo? Rode. Adicionou uma ferramenta nova ou mudou a descrição de uma existente? Rode também, porque descrições de ferramentas influenciam o comportamento mais do que parece.
Como as respostas variam, vale executar cada caso algumas vezes e olhar a taxa de acerto, não um resultado único. Se um caso passa duas vezes em três, isso é informação: ele é frágil, e frágil merece atenção mesmo que hoje "passe".
Se o conjunto roda em poucos minutos, você vai querer rodá-lo. Se leva uma hora, vai começar a pular. Mantenha o custo de execução baixo de propósito.
Registre as regressões
Aqui está a parte que mais me ajudou. Toda vez que o agente falha em algo real, esse caso entra no conjunto. Ele vira uma espécie de cicatriz: o erro aconteceu uma vez e nunca mais deve passar despercebido.
Mantenha um registro simples, com data, o que mudou (prompt, modelo, ferramenta), quais casos passaram a falhar e quais passaram a funcionar. Com o tempo isso vira um histórico valioso. Você descobre padrões, como "toda vez que encurto o prompt, os casos de recusa pioram", e deixa de repetir os mesmos tropeços.
E quando uma mudança melhora um grupo de casos e piora outro, o registro obriga você a decidir de forma consciente se a troca vale a pena, em vez de descobrir por acidente.
Armadilhas que eu já pisei
Overfitting no conjunto. Se você ajusta o prompt até todos os casos passarem, pode ter apenas decorado aqueles casos. Sinal de alerta: o prompt começa a ganhar instruções muito específicas, quase com o texto de um exemplo. Uma defesa é separar uns poucos casos que você nunca usa para ajustar e só consulta de vez em quando, como uma prova surpresa. Outra é renovar o conjunto com casos novos vindos do uso real.
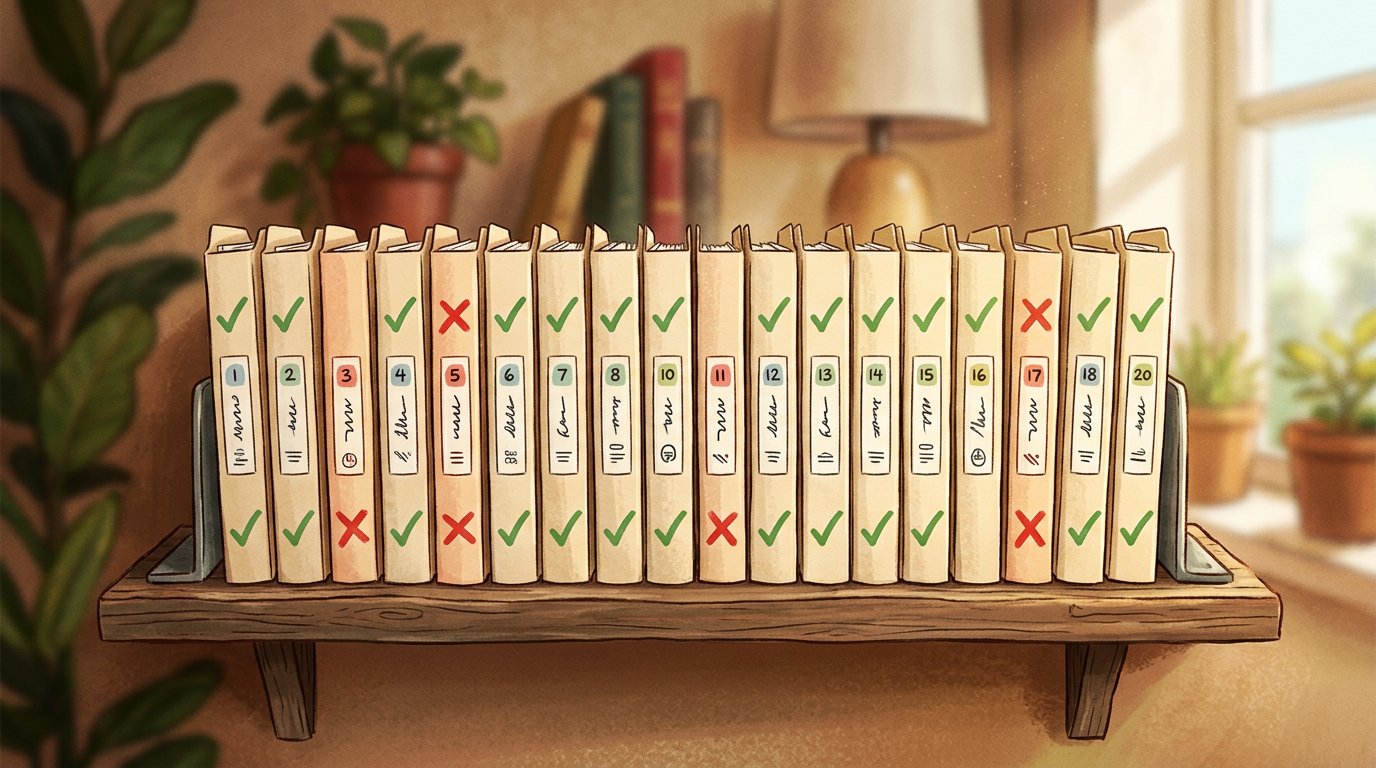
Métricas vaidosas. Uma porcentagem geral bonita esconde muita coisa. Noventa por cento de acerto pode significar que os casos fáceis estão ótimos e os que importam estão quebrados. Olhe por etiqueta, e dê mais peso aos casos em que um erro custa caro: ações irreversíveis, dados sensíveis, informação financeira. Também desconfie de métricas que medem o que é fácil, como tamanho da resposta ou velocidade, quando o que importa é resolver o problema do usuário.
Avaliador complacente. Um modelo juiz mal instruído aprova quase tudo. Se o seu eval nunca reprova nada, ele não está medindo nada. Teste-o de propósito com respostas ruins que você escreveu e confirme que ele as reprova.
Conjunto que apodrece. O produto muda, os casos ficam velhos e passam a cobrar um comportamento que ninguém mais quer. Revise de tempos em tempos e apague sem culpa o que perdeu o sentido.
Passo a passo para começar com 20 casos
Se você nunca fez isso, aqui vai um roteiro para uma tarde.
- Junte 20 situações reais. Tire de conversas antigas, tickets de suporte ou do seu próprio uso. Misture: uns casos comuns, uns difíceis, uns em que o agente deve recusar ou pedir esclarecimento.
- Escreva o resultado esperado de cada um. Em uma frase. Se você não consegue dizer o que seria uma boa resposta, o caso ainda está mal definido.
- Dê uma etiqueta para cada caso. Poucas categorias bastam.
- Escreva as checagens objetivas. Para cada caso, anote o que dá para verificar por código: ferramenta chamada, campos presentes, palavras que devem ou não aparecer.
- Adicione um juiz só onde precisar. Para os critérios subjetivos, escreva perguntas de sim ou não e teste o juiz com exemplos que você sabe que são bons e ruins.
- Rode o agente atual e guarde o resultado. Isso é a sua linha de base. Qualquer mudança futura será comparada com ela.
- Faça uma mudança de cada vez. Altere uma coisa, rode de novo e compare caso a caso, não só o total.
- Anote o que aconteceu. Uma linha no registro: o que mudou, o que melhorou, o que piorou, o que você decidiu.
- Alimente o conjunto. Cada falha nova que aparecer vira o caso 21, depois o 22, e assim por diante.
Vai sair imperfeito, e tudo bem. Um conjunto de 20 casos rodado com regularidade já pega uma quantidade surpreendente de regressões e muda a qualidade das conversas sobre o agente. Em vez de "acho que melhorou", passa a ser "esses quatro casos passaram a funcionar e esses dois pararam".
O que muda na prática
Depois que adotei esse hábito, a maior diferença foi emocional. Mexer no agente deixou de dar medo. Eu sei que, se quebrar algo, vou descobrir em minutos, não em semanas. Isso me deixa mais ousado para testar ideias, trocar de modelo e simplificar prompts que cresceram demais.
Evals não garantem que o agente seja bom. Eles garantem que você vai perceber quando ele deixar de ser. Comece com 20 casos, seja honesto com os resultados e deixe o conjunto crescer junto com o seu agente.